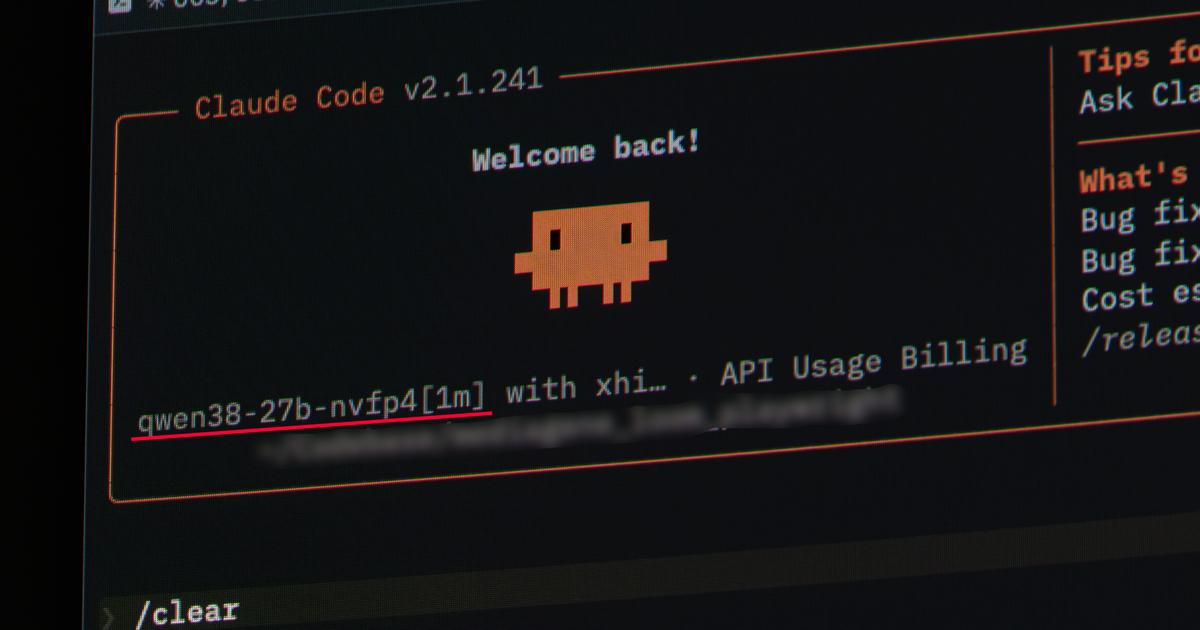
ローカルで動くAIモデルに業務を任せたとき、12時間以上ずっと考え続けて完璧な成果物を出してきたら、あなたはどう思うだろうか。Qwen3.8-27Bというモデルがまさにそれをやってのけて、一部界隈で話題になっている。
複数店舗を経営しながら開発もこなす立場として、業務自動化ツールの作成をAIに任せるシーンは増えている。だがここまで粘り強く、しかもローカル環境で動くモデルが登場したのは正直驚きだ。クラウドAIに月額課金せずとも、ハイエンドマシンさえあれば商用レベルの作業が完結できる可能性が見えてきた。
Qwen3.8-27Bとは何者か
Qwen3.8-27Bは、GPT-5.6 LunaやClaude Opus 4.6といった商用の大規模モデルに匹敵する能力を持つとされるローカルLLMだ。Mac StudioやDGX Sparkのようなハイエンド構成であれば実用的な速度で動作する。
最大の特徴は思考の深さと継続性にある。通常のLLMは応答速度を優先して思考を浅く保つ傾向があるが、このモデルは思考負荷が常に最高レベル(xhigh)に固定されており、小さなタスクでも時間をかけて徹底的に検証する。
関連アイテムをチェック
実際の使用例では、データ解析と自動化ツール作成という複雑なタスクに対し、12時間以上にわたってコードの実行・修正・再テストを繰り返したという報告がある。途中で投げ出すことなく、極端な条件下でも安定動作する実装を探り続けたというのだから驚異的だ。
12時間思考の中身を読み解く
なぜそこまで時間がかかったのか。思考ログを追うと、Qwen3.8-27Bは「安定性」を最優先に据えて動いていたことがわかる。
単にコードを書いて動けばOKではなく、考えられるあらゆる条件を想定してテストを繰り返していた。エッジケースや異常値が入力されても正常動作するか、メモリ効率は適切か、処理速度は許容範囲か——こうした検証を愚直に積み重ねていたのだ。
現場目線で言えば、これは非常にありがたい。開発者が「とりあえず動いた」で済ませがちな部分を、AIが自律的に詰めてくれるなら、本番環境への投入リスクが大幅に下がる。30分〜1時間かかっていた作業が5分に短縮されたという成果も、安定性あってこそだ。
店舗運営×開発の現場で使えるか
複数店舗を回しながらシステム開発もこなす立場だと、「速さ」と「確実性」の両立が常に課題になる。クラウドAIは速いが月額コストがかさむし、API制限もある。一方、ローカルLLMはコストを抑えられるが性能に不安があった。
Qwen3.8-27Bはその中間を突いてきた印象だ。初期投資としてMac Studioクラスのマシンが必要になるが、一度環境を整えれば月額費用ゼロで商用AI並の作業をこなせる。思考時間が長いのは確かにネックだが、夜間バッチや週次処理のような「急ぎでないが確実性が必要な業務」には最適だろう。
在庫管理の自動化、売上データの分析レポート作成、顧客対応テンプレートの生成——こうした定型業務の自動化に向いている。逆にリアルタイム接客支援のような即応性が求められる用途には不向きだ。
導入コストとランニングを考える
Mac Studioは約30万円〜、DGX Sparkはさらに高額だが、クラウドAIに月2万円払い続けるなら2年で元が取れる計算になる。電気代は増えるが、データを外部に出さずに済むセキュリティ面のメリットも大きい。
ただし、モデルのセットアップやプロンプト調整には技術的知識が必要で、非エンジニアがいきなり導入するのは難しい。開発者が1人でもいる体制なら検討の余地は十分ある。
まとめ:粘り強さが武器になる場面は確実にある
Qwen3.8-27Bは「速さ」ではなく「粘り強さ」で勝負するAIだ。12時間かけて1つの問題を完璧に仕上げる——人間なら根を上げる作業でも、このモデルは淡々とやり遂げる。
現場で使うなら、夜間や週末に重い処理を任せて朝には完成品が待っている、という運用が現実的だろう。クラウドAIの月額課金に悩んでいる開発者や、ローカル環境でのAI活用を模索している経営者にとって、選択肢の一つとして十分検討に値するモデルだと感じた。
参考: ギズモード・ジャパン「12時間、1つの問題を考え続けたAI。絶対に勝てないと思った」
※本記事にはAmazonアソシエイトのリンクが含まれます。